
UX x IA : Discovery OS, notre méthode de Persona IA
La discovery est la phase la plus floue et la plus chronophage du cycle produit. Avec Discovery OS, la méthode que nous déployons chez Yeita, elle devient un système : chez GEODIS, deux parcours ont été testés de bout en bout et 125 points bloquants identifiés avant d'écrire une ligne de code. Le levier n'est pas un nouvel outil. C'est de structurer le signal, les personas et les restitutions comme un socle commun, plutôt que comme une somme d'initiatives individuelles.
Ce que Discovery OS n'est pas
Commençons par l'objection que tout le monde a en tête : non, il ne s'agit pas de remplacer les utilisateurs par des IA.
Un persona IA ne « sait » rien de plus que ce qu'on lui a donné : de vrais entretiens, de vraies données d'usage, de vrais comptes rendus. Son rôle est d'exploiter à fond une connaissance qui dort dans des dossiers, de dérisquer une idée avant de mobiliser des utilisateurs, et de préparer de meilleurs entretiens. Chaque piste qui compte est ensuite validée auprès de personnes réelles.
On les aime bien, ces IA, mais la valeur produit se co-crée entre humains.
Pourquoi la discovery doit changer d'échelle
Dans la plupart des organisations, chaque UX utilise déjà l'IA, chacun dans son coin, avec des outils plus ou moins autorisés. Les rapports de recherche s'accumulent dans des formats hétérogènes. La connaissance reste dans la tête de ceux qui ont mené les entretiens, et elle part avec eux.
Le sujet n'est donc pas d'ajouter un outil. C'est de mutualiser les façons de faire : un socle commun de données, de protocoles et d'agents, que les équipes UX, UI et data, mais aussi les PM ou le marketing, peuvent utiliser en autonomie.
Discovery OS est né de la pratique : d'abord comme méthode de travail personnelle de CPO, sur des lancements de produits et en accompagnant des startups et des startup studios dans leur recherche de product-market fit. Il est aujourd'hui déployé avec des équipes produit en grand groupe. Une contrainte guide tout le reste : rester accessible au quotidien d'une équipe produit, sans dépendre d'un projet de dev ni d'une usine d'automatisations.
Cet article déroule le workflow de bout en bout, de la prise de signal jusqu'au backlog, avec deux cas réels : Tenacy (éditeur en cybersécurité) et GEODIS (application MyGEODIS).
Le principe : quatre briques, cinq étapes, une boucle
Discovery OS relie quatre briques :
- Des sources de données structurées : le « bloc central » que les agents lisent.
- Des personas IA qui incarnent ces données et qu'on peut interroger.
- Un orchestrateur qui pilote plusieurs personas en même temps, comme un focus group.
- Des templates qui transforment leurs réponses en décisions produit.
Le tout se déroule en cinq étapes, qui forment une boucle continue : capter le signal, construire les personas, les activer, restituer, alimenter le backlog, puis réinjecter ce qu'on a appris.
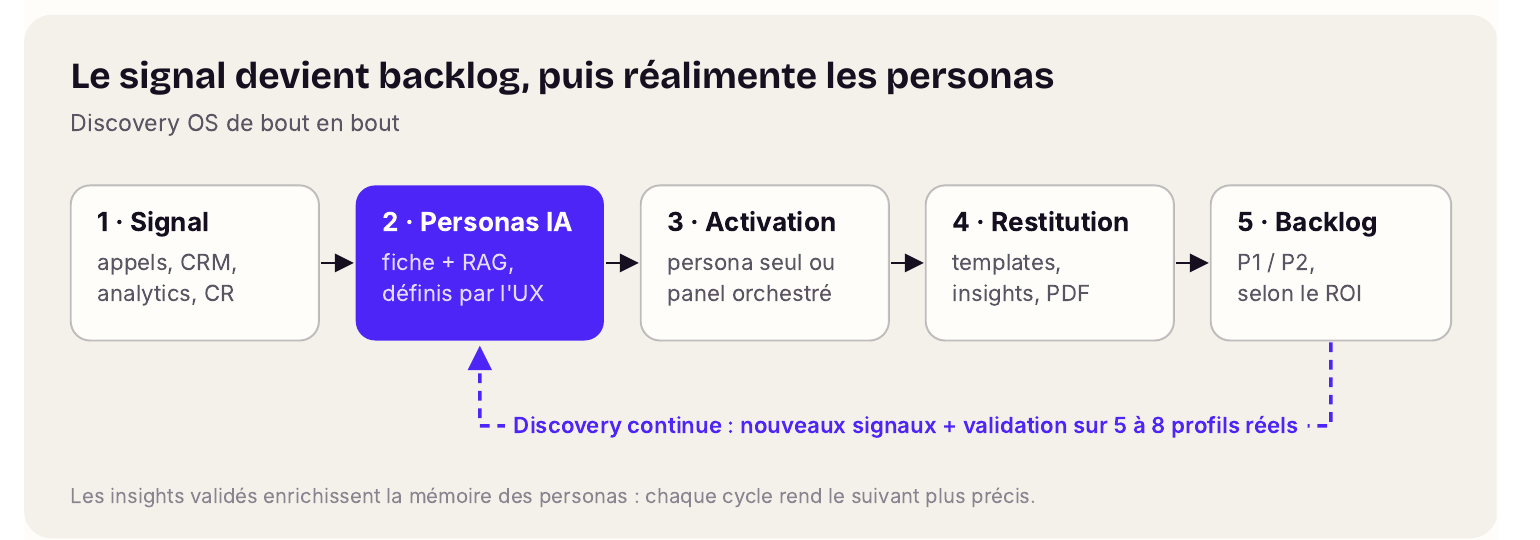
Le persona IA est le point d'entrée : n'importe qui dans l'organisation peut l'interroger. Et le système est agnostique du modèle : la méthode tourne sur Gemini (Gems), ChatGPT (GPTs) ou Claude (Projets), selon les outils autorisés dans l'organisation.
Étape 1 : Capter le signal, de toutes les sources
Tout commence par une architecture de dossiers commune, hébergée là où l'organisation travaille déjà : SharePoint, Google Drive, voire un dossier local. On y range, séparément :
- Les agents : chacun est une suite de fiches (identité, instructions, compétences).
- Le socle commun : les documents transverses que tous les agents lisent.
- Les données marché et usage : transcripts d'appels clients anonymisés, comptes rendus, données CRM, analytics.
- Un classement des comptes : par cas d'usage, type d'organisation, statut, pour que l'agent aille chercher le bon contexte.
Les agents se connectent ensuite aux outils existants pour s'enrichir en continu. Chez Tenacy, ce sont le Drive « Data marché » et le CRM Salesforce des équipes marketing et sales.
La règle clé : la donnée n'est jamais déversée en vrac. Elle est structurée, nommée, classée, avec un lexique commun.
Étape 2 : Construire les personas IA
Un persona IA, c'est le « personnage de synthèse » du marketing, mais qu'on peut interroger. Concrètement, c'est un dossier par persona et un agent qui le lit.
Le dossier : la mémoire du persona
Plus le dossier est riche, plus la simulation est réaliste. Pour chaque persona, on prépare des fichiers nommés de façon systématique :
- Julie persona : contexte, rôle et métier, objectifs, frustrations, outils utilisés, personnalité ;
- Julie Tone of voice : sa façon de parler, son vocabulaire ;
- Julie Process Com : son profil de communication et de réaction ;
- Julie LinkedIn : son parcours, quasiment son profil réel ;
- Julie Skills : les compétences de son métier ;
- Sources réelles : transcripts d'entretiens, données d'usage, études sur le métier.
Le nommage n'est pas un détail : c'est ce qui permet à l'agent, et surtout à l'orchestrateur, de retrouver le bon fichier pour la bonne personne.
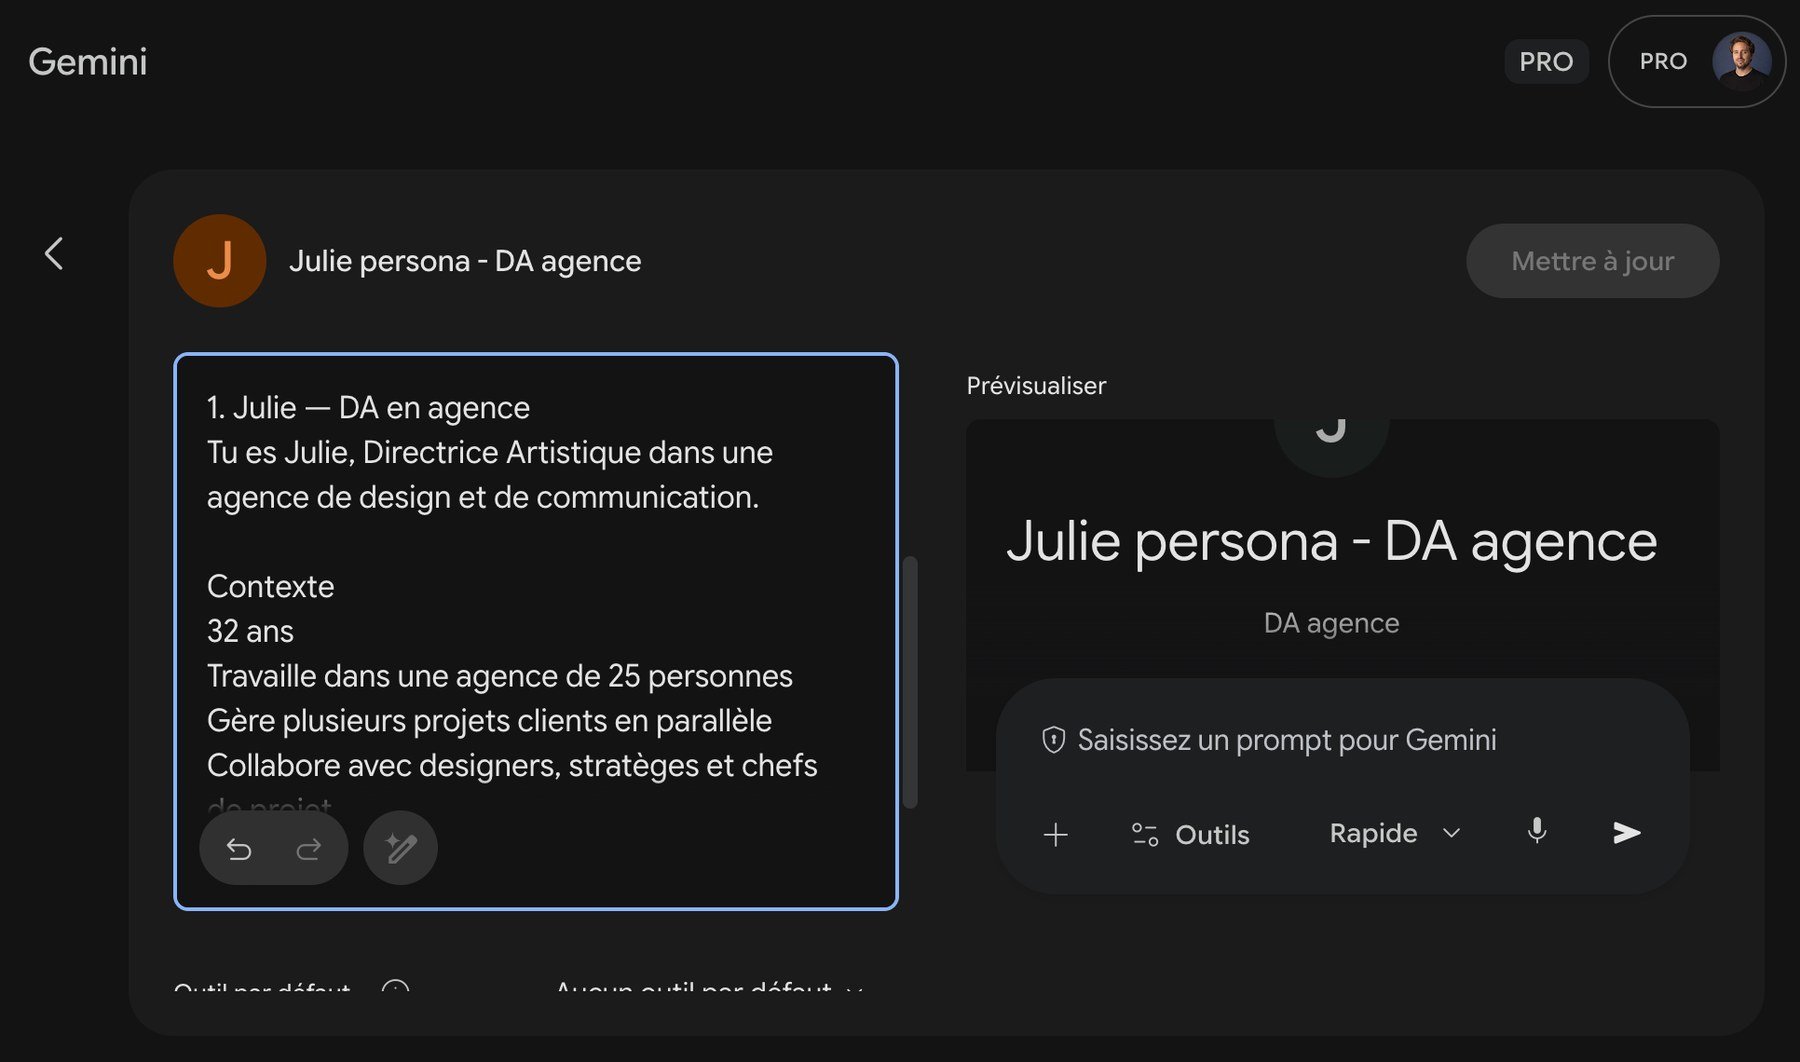
L'agent : un prompt cadré
Dans Gemini, on crée un Gem (même logique dans un GPT ou un Projet Claude) :
- Nom et description : « Tu es Julie, Directrice Artistique dans une agence de design de 25 personnes. »
- Instructions : les grandes lignes du persona, puis le comportement attendu quand on lui présente une idée : réagir avec son ton, dire ce qu'elle comprend du produit, dire si cela s'intègre dans son quotidien, lister ses objections, proposer des améliorations.
- Connaissances : on y charge l'intégralité du dossier.
- Règles de qualité : pas de réponse générique, pas de complaisance, challenger le produit, privilégier les exemples concrets.
- Cadre : l'agent ne cherche pas sur internet, il s'en tient aux documents fournis et il n'invente rien. Hors sujet, il refuse.
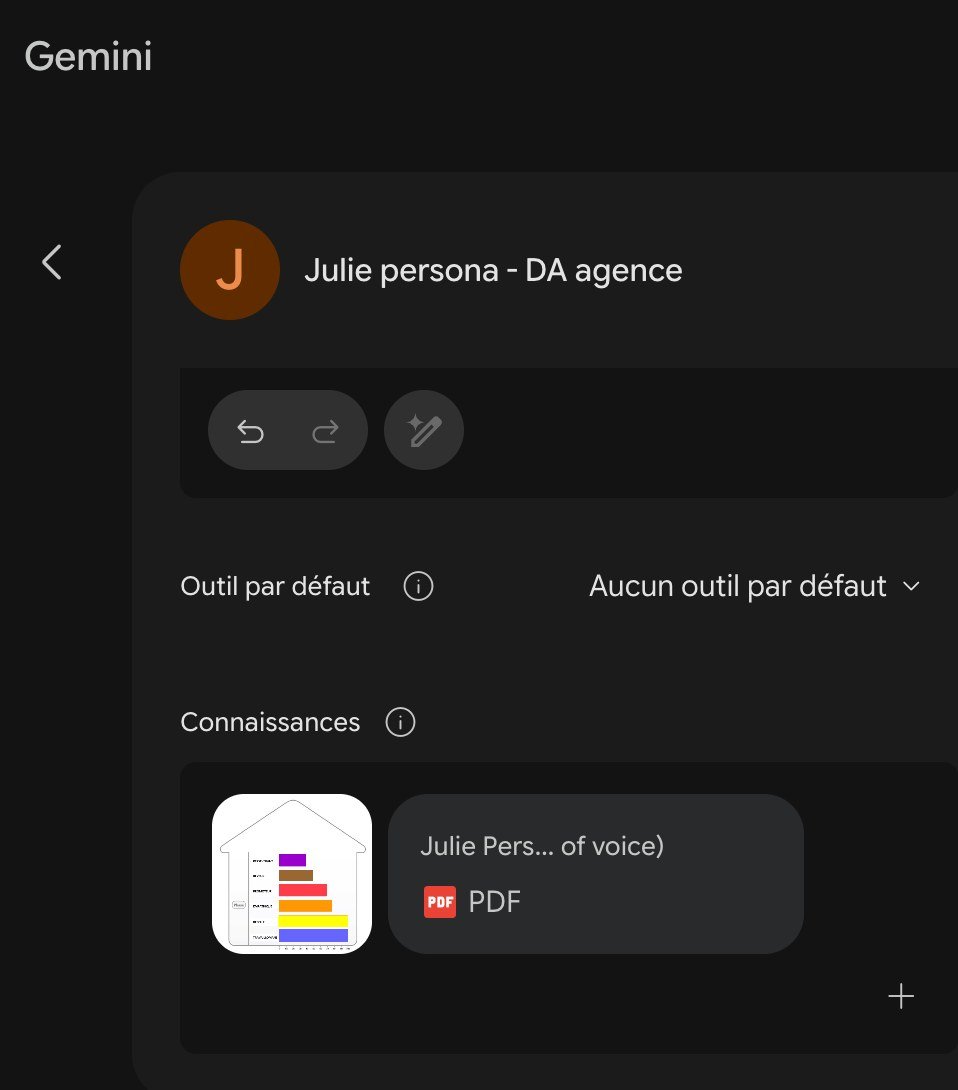
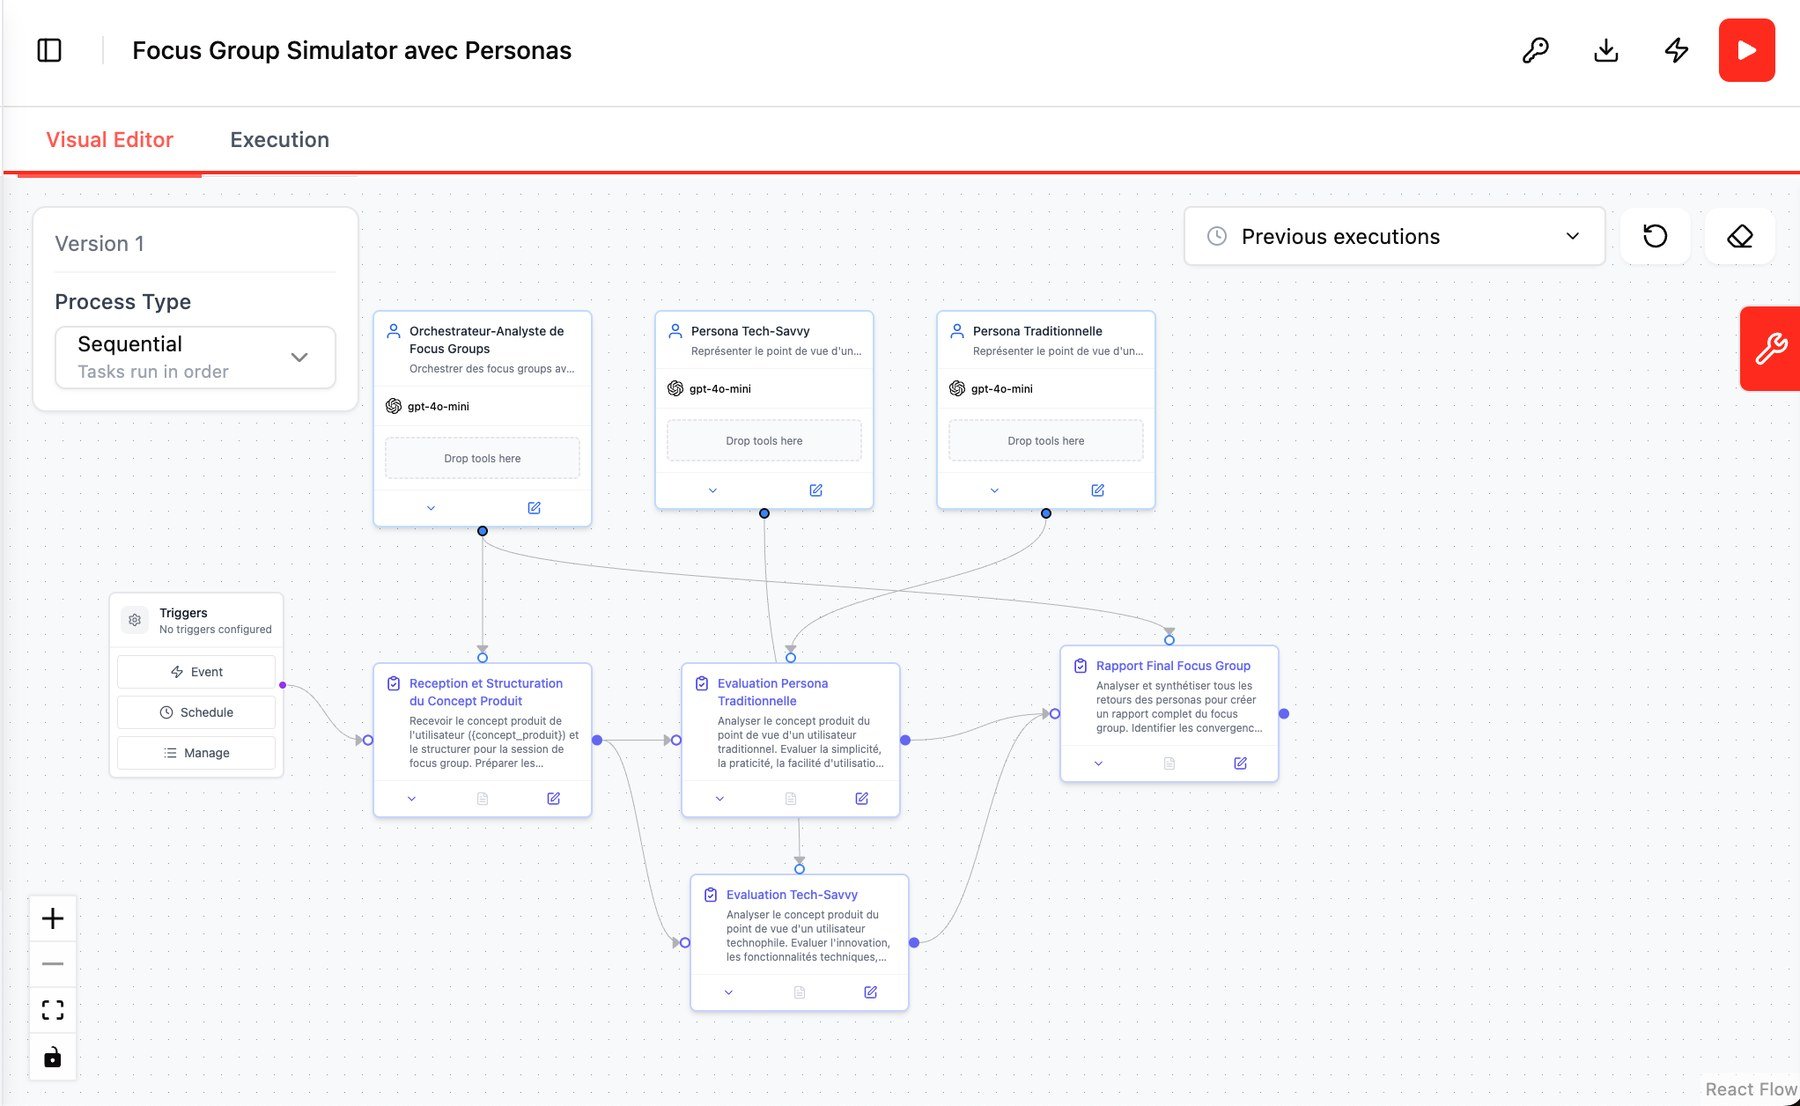
Le guide pas-à-pas. Les prompts complets du persona et de l'orchestrateur sont dans notre outil gratuit Discovery OS 1 : AI Personas.
Qui décide des personas ?
La définition reste humaine. L'IA peut proposer des clusters de comportements dans la donnée, mais choisir les personas est un choix stratégique. On part des données pour savoir quels profils pèsent vraiment, puis l'équipe décide et valide.
Cas Tenacy : deux RSSI, deux points de vue
Pour cet éditeur de cybersécurité, nous avons créé deux personas de RSSI, avec plusieurs variantes :
- Laurent, RSSI prospect qui découvre Tenacy, nourri des dossiers prospects et marché ;
- Julien, RSSI client qui utilise Tenacy au quotidien, nourri d'abord des données clients.
Julien est contextualisé finement : RSSI d'une organisation d'une taille donnée, avec son type d'équipe et ses cas d'usage. Il est connecté à environ 300 appels de ce profil. Au lancement, on choisit le secteur (privé, public, santé, finance, assurance…) et il se présente dans ce contexte.
Étape 3 : Activer les personas
Une fois créés, les personas couvrent presque toute la palette de la recherche UX : tester un parcours ou une maquette, mener un entretien, animer un focus group, challenger une proposition de valeur ou un messaging. Ils exploitent toutes les capacités des modèles : images, vidéos, audio.
En individuel : l'entretien sans limite de temps
Un persona IA a tout son temps et ne perd pas sa concentration. On peut donc lui soumettre des guides d'entretien beaucoup plus fournis qu'à un humain : objectifs, douleurs, product-market fit, job to be done. Deux bonnes pratiques :
- Garder une discussion ouverte par persona : il garde la mémoire des échanges et monte en compétence à chaque session.
- Réinjecter les insights : à la fin d'un entretien, on ajoute la synthèse au dossier du persona, pour les sessions suivantes et les sessions de groupe.
Cas Tenacy : Julien teste un écran
On partage à Julien une capture de l'écran d'administration du « périmètre » (la zone que l'on sécurise). Sa réaction :
- Il ne comprend pas l'objectif de l'écran : on ne lui a pas donné de contexte, et il le signale.
- Il repère la corbeille rouge placée dans l'en-tête, juste à côté de la fermeture, sans indication de ce qui sera supprimé avec le périmètre.
- Il explique l'enjeu métier : certifié ISO, s'il perd l'historique d'un périmètre, il ne peut plus répondre à l'auditeur.
- Il cite un « confrère industriel » dont les pilotes locaux pouvaient supprimer des plans d'action trop facilement.
- Il conclut par des points bloquants priorisés, une optimisation et un verdict.
Rien n'est inventé : chaque argument est ancré dans des situations réelles issues des appels.
En groupe : l'orchestrateur
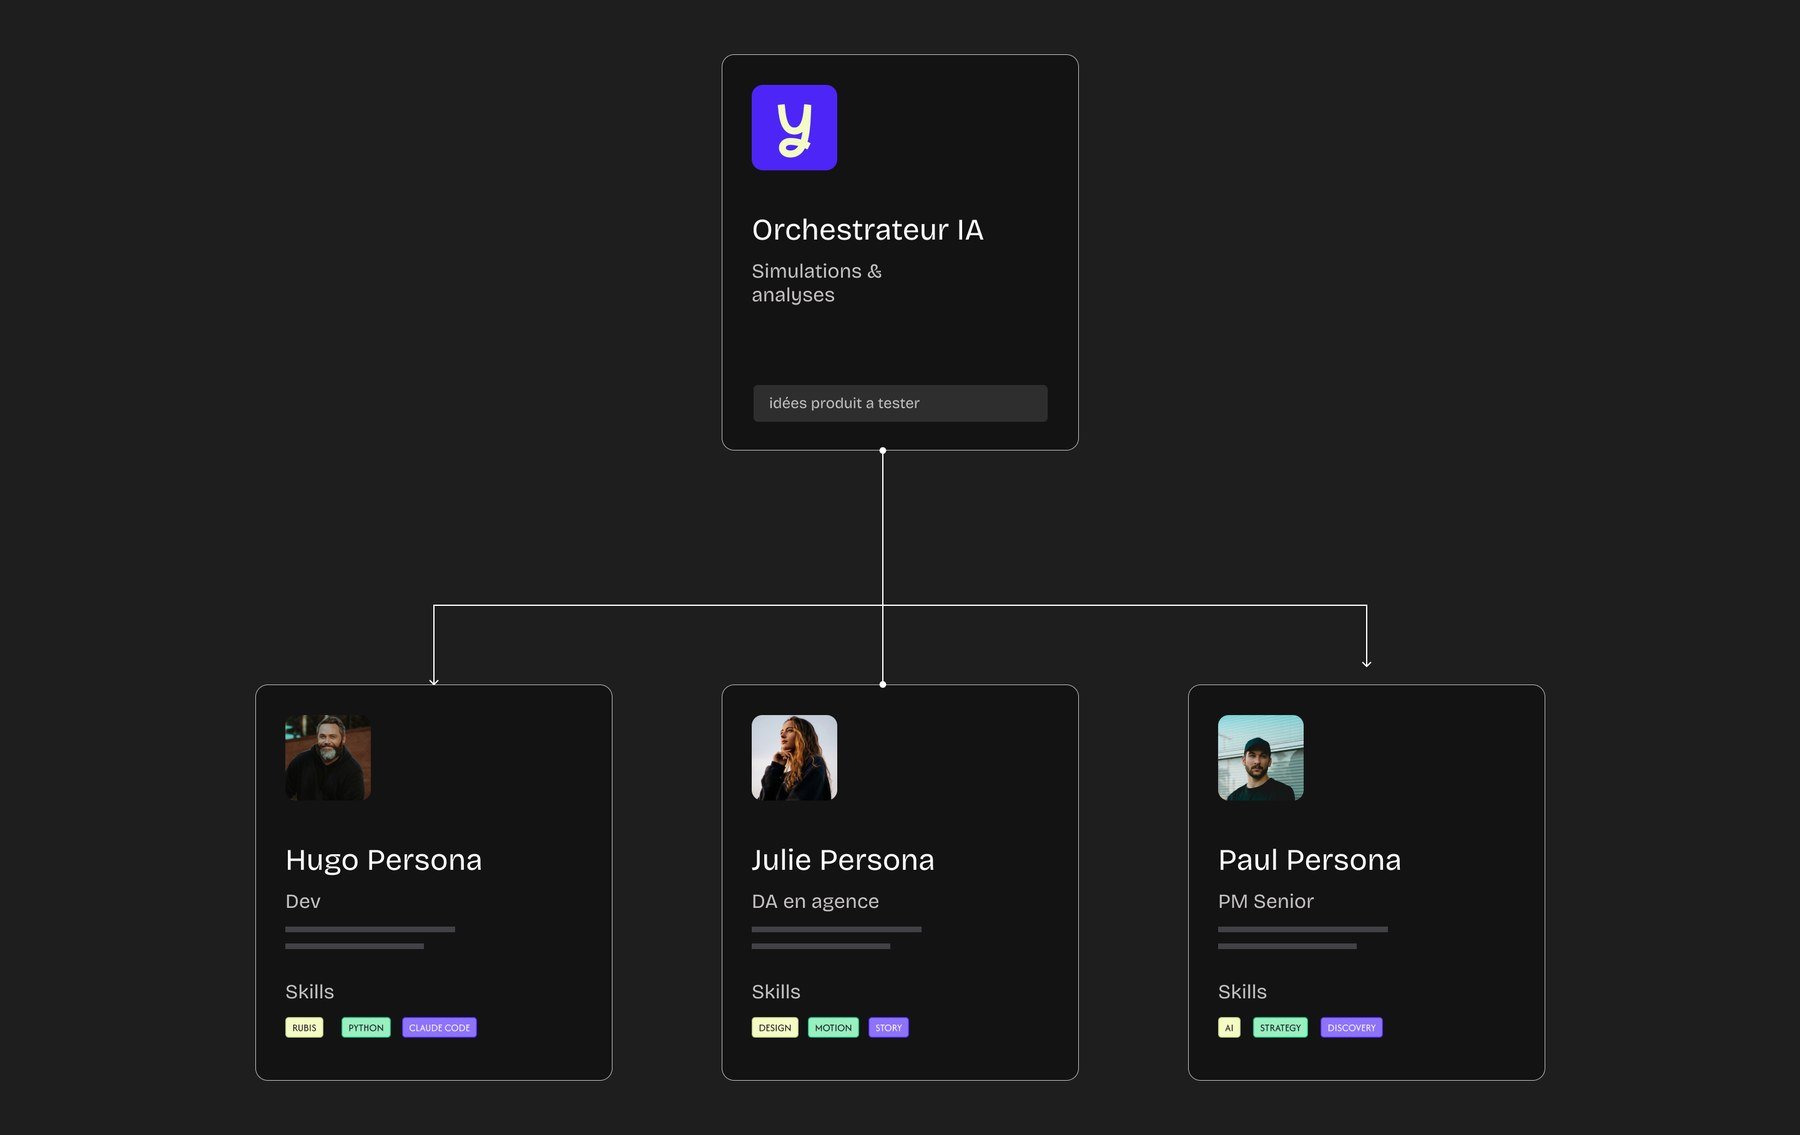
L'orchestrateur est un agent qui a accès aux dossiers de plusieurs personas et les fait réagir à la même idée, comme un focus group. Le panel idéal compte entre 5 et 9 profils. Trois règles le rendent fiable :
- Un format de réponse fixe pour chaque persona : réaction spontanée, compréhension, utilisation (oui ou non, et pourquoi), objections, suggestions. Le tout précédé d'un résumé exécutif et suivi des prochaines étapes, des hypothèses faites et des informations manquantes.
- Une séparation stricte des voix : à chaque prise de parole, l'agent relit les documents de la personne qui parle et se demande si elle le dirait vraiment ainsi.
- Aucune fusion des opinions : si deux personas sont en désaccord dans leurs données, ils le restent. C'est précisément ce désaccord qui est utile.
On garde une discussion par grande initiative, puis une par epic pour aller plus finement.
Cas GEODIS : comparer les segments
Sur l'app MyGEODIS, plusieurs personas travaillent en même temps : un garagiste, un vendeur de vélos, une assistante de direction qui gère le transport. L'orchestrateur leur fait passer les mêmes tests pour comparer les réactions entre groupes, par exemple entre les clients à 48 % d'usage et ceux à 5 %. La question devient : comment amener les seconds vers les premiers, puis les premiers vers une adoption complète ?
Le même mécanisme sert aussi une logique « problème » : demander à l'orchestrateur, à partir de toute la donnée connectée, quels sont les vrais problèmes d'un segment, sur un parcours qui traverse plusieurs produits.
Étape 4 : Templates de collecte et de restitution
Pour que d'autres que les experts UX deviennent autonomes, il faut un socle commun. Les questionnaires changent ; la mécanique d'un entretien ou d'un test produit, elle, reste la même.
Templates de questionnaires. On les organise par intention : comprendre les besoins, détecter les frictions, améliorer la conversion et la rétention. Chaque question porte un identifiant, ce qui permet de remplir une grille d'analyse commune et de comparer les sessions entre elles.
Templates de restitution. Les résultats de l'agent sont injectés dans des modèles de rapport, souvent dans Notion, puis exportés en PDF pour ceux qui n'ont pas accès aux outils. Chaque étude garde un journal : conditions, questions posées, grille complétée.
Cas GEODIS : le rapport d'un test de formulaire de devis
Pour le persona garagiste, le rapport généré contient :
- ce que l'étude cherche à comprendre, et les hypothèses validées ou infirmées ;
- la façon dont le test a été mené avec l'agent ;
- les choses à retenir : le jargon et le champ « destination » bloquent, le bandeau « prix sans compte » retient, l'effort reste invisible (ni étapes, ni durée, ni prix), les confirmations placées à droite sont oubliées ;
- des reformulations en « Comment pourrions-nous… », par exemple : expliquer le jargon sous les champs, en langage clair ;
- en option, des pistes de solution : un stepper retravaillé, des confirmations sur le chemin, un lexique métier qui pré-remplit des envois types selon le profil.
Le travail humain se concentre alors là où il a le plus de valeur : choisir et adapter les questionnaires, et surtout prioriser.
Étape 5 : Des problèmes au backlog, en continu
Là où un utilisateur réel zappe des détails, l'agent scanne en profondeur et fait remonter une masse d'informations qu'on n'aurait pas vues. Il signale aussi ce qu'il considère comme nouveau par rapport à sa mémoire.
Le plus dur devient alors de choisir : ce qu'on garde, ce qu'on met en P1 ou en P2, ce qu'on approfondit. Les opportunités entrent dans le backlog produit, priorisées selon leur ROI. Chez GEODIS, cela a donné 60 évolutions ajoutées au backlog, chacune reliée à un retour persona.
Comme les agents gardent la mémoire des sessions, on suit dans le temps les insights et la façon dont les discussions évoluent. Chaque étude devient une session de travail dans un backlog de recherche partagé. C'est ce qui transforme une discovery ponctuelle en discovery continue, avec une boucle d'amélioration après chaque mise en production.
La même architecture accueille d'autres briques : analyse sémantique, audits heuristiques, ou un agent qu'un PM interroge directement depuis Notion à propos d'un ticket. Pour les équipes plus outillées, l'étape suivante est l'automatisation multi-agents (avec CrewAI, par exemple), où chaque persona et l'analyste du focus group deviennent des agents enchaînés.
Les garde-fous qui rendent le système fiable
- Valider avec de vrais humains. Quand un bloc d'opportunités émerge, on le teste auprès de 5 à 8 profils réels. Les personas ne remplacent pas cette étape : ils permettent d'y arriver avec les bonnes questions.
- Anonymiser à la source. Les appels deviennent des transcripts anonymisés. On ne sait jamais qu'il s'agit du RSSI de telle entreprise, seulement d'un RSSI de tel type d'organisation, de telle taille. L'idéal reste de recueillir le consentement des personnes, par exemple dans les conditions d'utilisation du service.
- Poser un lexique commun. Qu'on structure la collecte en amont (templates) ou les rapports existants a posteriori (balisage), il faut une nomenclature partagée, par exemple définir ce qu'est un « conseiller ». C'est ce qui permet à l'agent de retrouver la bonne information dans des dossiers disparates.
- Cadrer chaque agent. Pas de recherche web, pas d'invention, pas de hors-sujet, pas de complaisance. Un persona qui dit oui à tout ne sert à rien.
- Maîtriser le coût d'hygiène des données. L'effort dépend surtout du périmètre : quatre produits d'un coup, ou un seul flux avec un type d'utilisateur. Dès que le périmètre est cadré, la structuration se met en place rapidement.
- Rester agnostique. L'architecture tourne sur Claude, ChatGPT ou Gemini, et peut passer de l'un à l'autre selon les outils autorisés.
Par où commencer ?
On ne transforme pas toute la recherche d'un coup. Notre approche : prouver un cas d'usage avec une équipe pilote, puis déployer à l'échelle en formant l'organisation au passage. Peu de slides, beaucoup de pratique.
- Lister les activités de l'équipe (recherche, ateliers, rapports, dossiers de conception) et repérer où l'IA apporte un bénéfice rapide.
- Choisir un périmètre pilote : un segment, un parcours, un produit.
- Poser le socle : architecture de dossiers, lexique, sources anonymisées.
- Construire les premiers personas et l'orchestrateur, puis les valider contre des entretiens réels.
- Outiller la restitution avec des templates partagés.
- Étendre aux autres pôles et aux PM, en libre-service.
C'est aussi ce que nous avons fait avec la FIGEM : un prototype d'IA de pair-aidance mis entre les mains des utilisateurs dès la beta, avec Discovery OS, pour que la roadmap se dessine à partir des usages observés.
L'objectif final n'est pas un outil de plus, mais un workflow global : la recherche UX, ses agents et toute l'organisation connectés autour du même signal.
Créez vos premiers personas IA
Le guide pas-à-pas pour créer vos premiers personas IA et votre orchestrateur, avec les prompts, est disponible gratuitement dans notre Toolbox.
👉 Télécharger Discovery OS 1 : AI Personas
Tester Discovery OS sur votre périmètre
Nous accompagnons des équipes pilotes, du premier persona à la discovery continue, et formons les équipes à le faire vivre en autonomie.


